Google 重磅发布 Genie 4:世界模型终于活了
Google 重磅发布 Genie 4:世界模型终于活了
内容摘要
谷歌这次玩真的了:AI 生成的世界开始有声音了,世界模型要进入新的level了。就在今天凌晨,Google DeepMind 官宣了 Genie 4。官方给它的
谷歌这次玩真的了:AI 生成的世界开始有声音了,世界模型要进入新的level了。
就在今天凌晨,Google DeepMind 官宣了 Genie 4。官方给它的定位是:我们迄今最具交互性的世界模型。
重重重要的是!它是 DeepMind 第一个原生生成音频的实时世界模型。官方发布视频里所有能听见的声音,全部由 Genie 4 自己生成。
除此之外,Genie 4 还把物理运动、人物动作和实时控制又往前推了一步。
世界模型到底是什么,先看谷歌官方展示的一个案例。
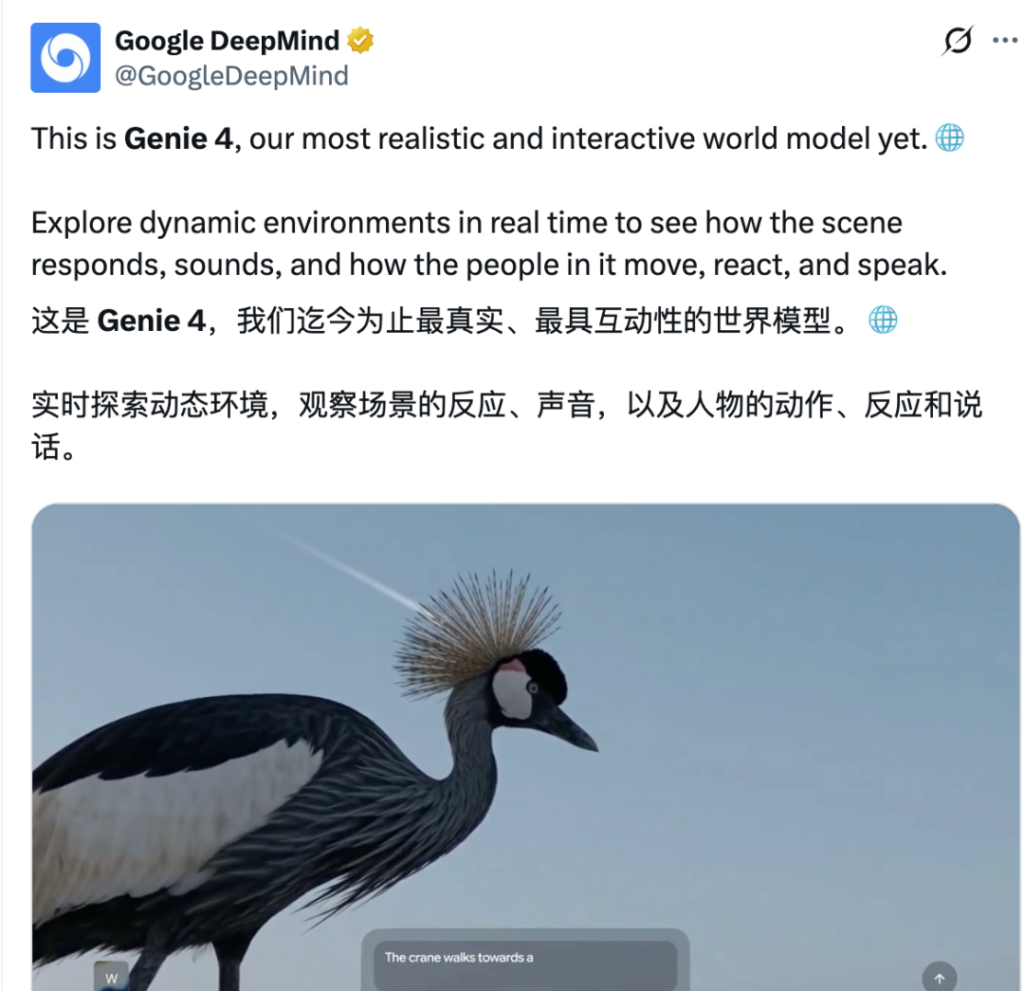
起点只有一句话:冠鹤走过雪地,黄昏的天空渐变,纪录片风格。
画面里就是一只冠鹤,在冰天雪地里走。画面左下角亮着 WASD 键,右下角是方向键,镜头一直贴着它。
然后,输入框里敲进一行字:一颗流星划过天空。
天上真的划过一道白线。
再敲一行:冠鹤走向一台白色钢琴。
雪地上多出一台电子琴,冠鹤低下头,凑过去,把喙按在琴键上。
最后一行:冠鹤展开翅膀,飞起来。
冠鹤张开翅膀,从琴边腾空而起,身后的雪地、那台琴、天上的流星,都还在原地。
一次输入,一个事件,每一步都是现场算出来的,没有一个镜头是提前拍好的。
说实话,世界模型这个概念,过去一年多每隔几周就要冒出来一回。
Genie 自己这一路,已经走了三个版本。可这次不一样,它让世界模型活过来了。
◽跟上一版本比,差距一眼就看出来
想知道 Genie 4 到底强在哪,我们拿它跟上一版本比一下就清楚了。
谷歌官方放出了一组同屏对比,两边生成的都是剧院后台。
左边是 Genie 3。右边是 Genie 4:镜头切进一条忙碌的后台走廊,演员在补妆、整理服装,旁边挤着衣架和设备,帘子、镜子和暖光灯泡把空间填得满满当当。镜头走进去,看到的不只是一间布置好的屋子,还有一群正忙着的人。
同样是剧院后台,Genie 4 生成的画面里多了更多人物和细节,人物动作也更自然。镜头走进去,看到的不只是一间布置好的屋子,还有一群正在忙碌的人。
所以这次的升级,不只是让世界看起来更清楚:人动得更自然了,场景有了声音,物体碰撞时也能生成相应的变化。
接下来我们先说第一个:声音。
◽每个世界,都带着自己的声音
前面几代生成的世界模型,比如风在吹,叶在晃,浪在拍岸,什么声音都没有。
当然不是谷歌忘了做,因为前期让声音和画面在同一帧里对上,并且保持连贯要难得多。
而这次官方的亮点就是,让每个世界都带着它自己那套环境声,从林间的风,到拍上岸的浪。
从官方演示里的一段就能看出来。
一片平台浮在寂静的湖中央,远处是雾林,天是淡蓝灰的阴天,中间悬着一颗暖黄色的球,一个穿宽松棕色西装的中年男人站在上面吹萨克斯。
提示词要求人自然地继续吹,带着细微的呼吸、手指动作和身体轻晃。
声音那一栏是这么写的:自然的湖面环境声、远处的风、轻柔的水声,以及真实的萨克斯声;除了场景里物理存在的乐器,不要额外加背景音乐。
Google 要的不只是有声音,是这声音得从这个世界里长出来。
另一段是第一人称龙骑士,骑着黑色巨龙以 140 公里时速冲过山地竞速赛道,音频栏写着:深沉的振翅声、高空风声、远处的火山轰鸣、火星噼啪。
光有声音还不够,Genie 4 引入了实时互动对话。
◽角色能互动对话,还能回应指令
官方把人类语言称作真正的难关。这一次引入了实时互动对话,角色之间能对话,也能对用户的操作和世界里发生的事做出反应,全程实时。
另一方面,这次最明显的飞跃,是模型模拟人的能力,让动作自然、对环境有反应、还能被实时操控。
在下边这段演示中就可以看到 Genie 4 的能力。
一座 1980 年代的日本乡村车站,红色列车停在站台边,一位戴大檐帽的站务员走在人群前面。
输入框里敲一句:他广播下一班列车发车。
再敲一句:一位老妇人拎着手提箱赶来。
镜头沿着车厢一路扫过去,一位白发老妇人拎着棕色皮箱,真的从画面边上走了进来。
另一个更有意思的例子,来自拿到早期访问的宾大教授 Ethan Mollick。
他先让 Genie 4 生成一座住着机器人和马的城市,又在场景里加入了一只友好的水獭角色。
他让水獭过来提问,画面里的水獭随后出现,还开口搭了话。
这个世界真奇妙,角色能开口,能接话,还能对用户的指令和世界里发生的事当场做出反应。
人物的反应自然了,接下来的物理运动才是更逼真。
◽物体碰撞更自然,变化也能接着生成
前几个版本的 Genie 也展示过水、重力和物体互动。到了 Genie 4,Google 希望它能把碰撞、空气动力学等场景模拟得更逼真。
官方演示:一只完整的西瓜放在石台上,随后,一尊沉重的大理石半身像砸下来,西瓜被压碎,红色果肉散开。
看起来只是“砸了个西瓜”,对模型来说,却要接着生成碰撞之后的画面:雕像落下来,西瓜破开,果肉散到周围。每一步都得和前面的场景接得上。
还有一段画面,是一条长长的粉色绸缎铺在花草之间。随着风吹过,轻薄的布料扬起来,在草地上起伏。
现在我们已经看到,这个世界模型可以实时修改正在发生的世界,可以让物理运动和人物行为更逼真。
这么多事同时在跑,那么谁负责让后面的世界接着演下去?
答案是套分工。
◽Gemini 当导演,Genie 负责把世界演出来
我们可以把它想成片场:Genie 是演员,Gemini 是导演。
导演干的活是一串:看当前画面 → 拆解目标 → 安排下一步 → 检查这一步成没成 → 根据变化临时改计划。
Gemini 3.8 Flash 模型就是导演,它在环里当引导智能体:Genie 一边实时生成世界,模型它就一边观察场景、把目标拆成一步一步的动作、回看进来的每一帧、核对上一步到底有没有成功。
世界一变,或者我们一下指令,它当场改计划。
官方把可靠的因果、程序化行为和多步推理这套东西,归功于这个循环。
分工大致是这样:
Genie 4 负责把世界的画面和声音演出来。Gemini 3.8 Flash 负责盯着、拆着、接着、查着。Gemini Omni 提供外观和行为方面的基础,把模拟锚在真实世界该有的样子上。
这么折腾,是为了解决一个老问题:多步骤的事,靠纯像素生成根本接不住。
让一个角色走到桌边、伸手、拿起杯子、喝一口,中间任何一步接歪,整个动作就散了。有语言模型在旁边盯着,才谈得上把一件事做完。
这也是谷歌自己提到的下一步方向:把语言和代码那种结构化的推理,跟像素级的感官模拟合到一起。
用他们的话说,Gemini 在幕后规划结构和叙事时间线,Genie 生成眼前的物理现实,世界长什么样、听起来什么样、怎么回应,一笔一笔画出来。
◽测试者已经玩上了,但世界模型还不太完美
道理讲完了,这东西真到了人手里,会被玩成什么样?
宾大教授 Ethan Mollick 在自己的电脑上敲下一行字:一座住着机器人和马的新哥特式粗野主义城市,大约一分钟,城市就出来了。他接着要龙,再要一只友好的水獭 NPC,全程实时。
他的评价是:相当疯狂的一次体验,只是并不完美。
a16z 合伙人 Justine Moore 也拿到了提前访问。她说,这是从一个起始提示(环境加角色)就生成的、完全可交互的世界,感觉是巨大的一步跨越,现在可以提示着去改变这个世界,并与之互动,还带原生音频。
热闹归热闹,并不完美 这四个字,谷歌自己也写在了发布页上。
谷歌承认:视觉细节和物体会随时间漂移,世界模型跑得越久、提示词改得越多、在场景里走得越远,越明显
这个世界会失忆。
官方模型页还写明,模型支持的只是数分钟的连续交互,不是长时间会话。
想在里面待一下午,现在还不行。
目前的使用门槛也还是有的。Genie 4 现在是研究预览,只给一小批可信测试者。之后才轮到 Google AI Ultra 订阅用户在 Project Genie 里用,以及 Gemini API 和 Google AI Studio 的早期合作伙伴,官方已经挂出候补名单。
尽管现在还并不完美,门槛也是有的。但 一句话,一个世界。Genie 4,这次真的不一样。
参考文献
[1] https://deepmind.google/blog/genie-4-a-new-generation-of-world-simulation/
[2] https://blog.google/innovation-and-ai/models-and-research/google-deepmind/introducing-genie-4/