Gemini 4 Carbon 发布,重回巅峰
Gemini 4 Carbon 发布,重回巅峰
内容摘要
谷歌最近这更新速度,是不是有点太快了?两周前,Gemini 4 Argon 刚刚向更多用户开放。很多人可能还没来得及把它摸透,谷歌又推出了一个更强的模型:Gem
谷歌最近这更新速度,是不是有点太快了?
两周前,Gemini 4 Argon 刚刚向更多用户开放。很多人可能还没来得及把它摸透,谷歌又推出了一个更强的模型:Gemini 4 Carbon。
就在今天凌晨,Google DeepMind 正式发布 Gemini 4 Carbon,称它是谷歌目前最强的模型。
Carbon 是“碳”,Argon 是“氩”,从氩到碳,谷歌这次相当于带着大家重温了一遍元素周期表。
而且这次一出手,就冲上了榜首。
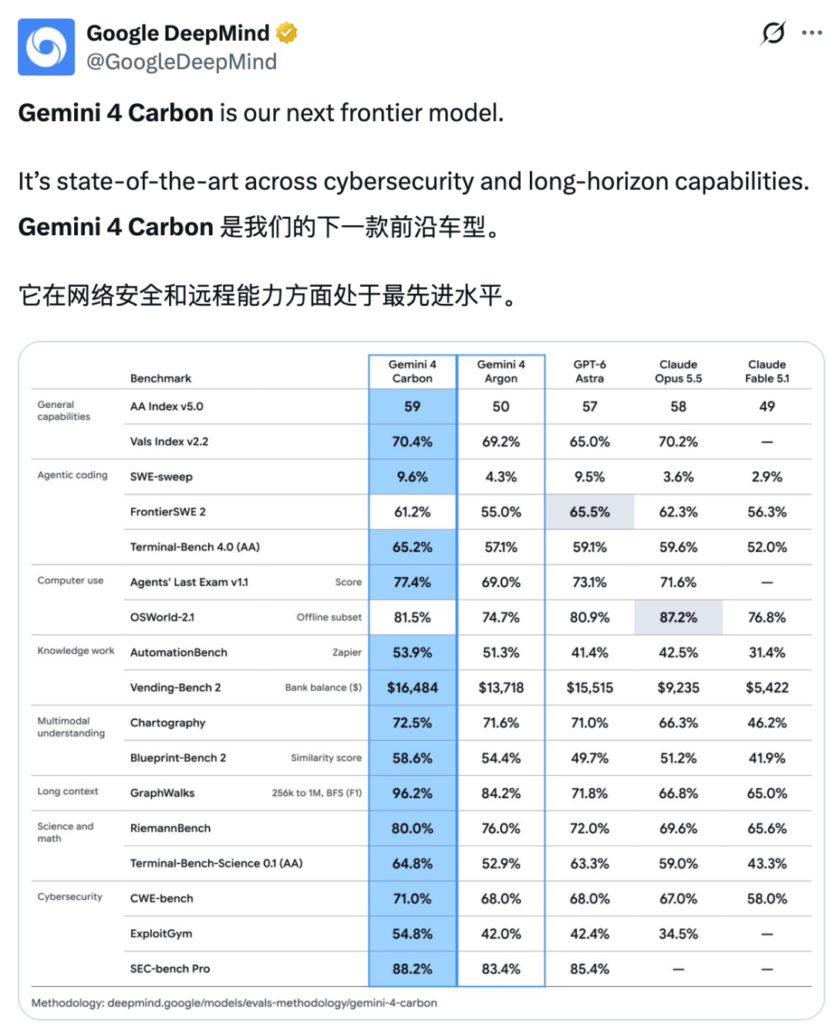
在第三方评测机构 Artificial Analysis(下文简称 AA)的智能指数上,Carbon 拿到 59 分,排在 Claude Opus 5.5(58 分)和 GPT-6 Astra(57 分)前面。
而这次模型发布,官方也是主打两件事:网络安全防御和长时间处理复杂工程任务。
不过先说清楚:Carbon 现在还用不上。这周只有一小部分网络安全防御者能用,开发者和普通用户都还得等。
重回巅峰有多难?谷歌上一次坐到这个位置,还是今年 2 月。
◽谷歌重回综合榜首
今年 2 月,Gemini 3.1 Pro Preview 登上 AA 智能指数第一。AA 当时的原话是:谷歌再次成为 AI 领域的领导者。
之后,谷歌的旗舰模型就断了档。
谷歌 CEO 劈柴(Sundar Pichai)说好 6 月发布 Gemini 3.5 Pro,结果一拖再拖。到了 9 月 30 日,谷歌发言人向路透社确认:3.5 Pro 不发了。
10 月 13 日,谷歌宣布 Gemini 4 Argon,这一次也是因为谷歌一直不断的“追赶” Anthropic 和 OpenAI,才让它重新回到了前三家实验室。
15 天后,也就是今天,Carbon 来了。这一次直接重回巅峰。
这个巅峰,是在 AA 刚改版的新榜单上拿下的。
AA 智能指数可以把它理解成大模型的综合排名:AA 用同一套题,把写代码、做科研、知识问答、办公智能体等 9 项测试挨个跑一遍,合成一个总分。
其实在昨天 AA 刚把智能指数升级到 v5.0。那个时候新榜单前五名全是 Anthropic 和 OpenAI 的模型。Opus 5.5 以 58 分排第一,Argon 50 分,排在它们后面。
结果一天之后,第一就换人了:Carbon,59 分。超过了Claude Opus 5.5(58 分)和 GPT-6 Astra(57 分)。
好家伙,榜单前脚刚改版,后脚就被谷歌拿下了。
连马斯克都转发了劈柴的官宣帖,只评了一个词:Impressive(令人印象深刻)。
当然谷歌自己的成绩单同样好看。官方列了 17 项对比,Carbon 拿下 15 项第一。
只有两个榜单成绩不是SOTA。
一项是软件工程测试 FrontierSWE 2,输给了 GPT-6 Astra(65.5% 对 61.2%);另一项是电脑操作测试 OSWorld-2.1 的离线子集,输给了 Opus 5.5(87.2% 对 81.5%)。
总榜讲完了。但谷歌这次真正想让我们看的,其实是网络安全防御和长时间处理复杂工程任务。
◽网络安全三项全拿第一
想象一个场景:一家医院的系统里藏着一个漏洞。守系统的人要做三件事:先把漏洞找出来,再确认它能不能被攻击者利用,如果真能被利用,最后需要它补上。
谷歌把这套操作叫作“网络安全防御全流程”,而 Carbon 在每一步都有成绩。
先看发现漏洞这一步。SEC-bench Pro 把模型放进真实软件里,看它能不能自己挖出藏得很深的漏洞。Carbon 拿到 88.2%,Argon 是 83.4%,GPT-6 Astra 是 85.4%。
接着是验证漏洞是不是能被攻击者利用。这一步的作用是确认漏洞该不该优先修补。
ExploitGym 测的就是这个。Carbon 拿到 54.8%,Argon 和 Astra 都只有 42% 左右,Opus 5.5 是 34.5%。
这一步进步最大,比 Opus 5.5 整整高出 20 个百分点!!
最后是修复漏洞。CWE-bench 考的是能不能从根上修好,直接写出能用的修复代码。Carbon 是 71.0%,Argon 和 Astra 都是 68%,Opus 5.5 是 67%。
在谷歌公布的对比里,这三项 Carbon 都是第一。
谷歌还报了内部数字。一是写安全代码的成功率是 Argon 的 2 倍多;二是 Chrome 团队说,生成高质量补丁时,Carbon 比“另一家实验室的大型前沿模型”强 10 倍以上。
至于是哪一家,谷歌没说。
会找漏洞,还会修复漏洞,听起来已经很有用了。但真到了大型工程里,问题往往还没这么简单:有些 bug 一路追下去,可能要花上好几天。
那 Carbon 能坚持多久?
◽专门为长程复杂任务打造
谷歌给的答案是:好几天。
这也是接下来Carbon的第二优势了,连干好几天复杂工程任务。
谷歌称,Carbon 就是朝着这种长时间、多步骤工程任务打造的。
谷歌表示,内部团队已经观察到 Carbon 持续运行数日,处理大型代码库和底层系统中的复杂任务,包括追查那些不容易发现的 bug 的根因,以及尝试修复它们。
DeepMind 的帖子也直接说明了:Carbon 能连着干好几天,不卡壳,也不走捷径。
成绩上,在终端里做工程任务的 Terminal-Bench 4.0 上,Carbon 是 65.2%,比 Argon 的 57.1% 高了 8 个百分点。
但让 AI 连着干几天,最怕的其实不是它慢,而是它糊弄。
这次谷歌专门晒了这方面的数据。在 Terminal-Bench 4.0 上,Carbon 钻测试空子、成功作弊的比例降到了 0,连尝试作弊的比例也只有 0.4%。
在谷歌内部的真实编码环境里,高严重度的“不对齐”警报少了将近 80%。不对齐就是模型干的事和人想要的对不上。
没有依据的说法,也比 Argon 少了一半左右。证据不够时,Carbon 会把缺口直接写进交付物,或者列清楚还差什么,不编一个出来。
问题来了:这么好用的模型,什么时候轮到我们?
◽模型发布得飞快,轮到我们用却还得等等
答案是:先等着。
谷歌给 Carbon 排了一条长队。这周先给一小部分网络安全防御者,接着通过 Fairwind 计划一点点放给更多可信伙伴,开发者、企业和普通用户排在最后,时间是“尽快”。
至于“尽快”是多快,官方没给日期。
这个节奏,谷歌自己也不避讳。官博原话说,这次发布采取“deliberate”的方式。这个词可以翻成“审慎的”,也可以翻成“故意的”。
谷歌CEO 劈柴也在发文最后提前安抚了一句:so hang tight!(稍安勿躁!)
虽然暂时还没轮到我们用,谷歌已经先把价格公布了。
推广价是每百万 token 输入 2 美元、输出 10 美元,缓存命中的输入再便宜 95%,和 Argon 一模一样。推广期过后,涨到 4 美元 和 20 美元。
从 Argon 扩大开放,到 Carbon 发布,中间只隔了 15 天。谷歌这次,确实来势汹汹。
参考文献
[1] Google: https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon/
[2] Google DeepMind: https://x.com/GoogleDeepMind/status/2115489356437651654